2026 年(第 19 届)中国大学生计算机设计大赛 · 人工智能实践赛作品报告
作品名称:颐养轩 · 多模态的人工智能康养服务平台 · 获奖:中国大学生计算机设计大赛 国赛二等奖
颐养轩是一个面向机构养老场景的多模态人工智能平台。它把三件事拼在一起: 边缘侧的实时视觉监测(YOLO + 状态机)、云端的多模态决策验证(VLM + LLM), 以及一个能用自然语言操作的业务系统(LLM Agent 智慧中枢)。
下面这份是参赛时提交的完整作品报告,包含问题分析、技术方案、系统实现与三组对比实验。
第1章 作品概述
1.1 项目背景与研究意义
当前我国人口老龄化进程显著加快,根据国家统计局及相关预测数据[1,2,3],我国老龄人口占比持续上升(如表1.1 所示),养老服务体系正面临空前的长期压力。在此背景下,现有养老机构虽已普及基础信息化系统,但养老监护过度依赖人工巡检,监控缺乏自动分析能力,导致紧急风险很难被实时发现;同时护工深陷于排班、日程及药事管理等繁杂的事务记录工作,负担较重。因此,融合人工智能、物联网与大数据,构建具备风险主动干预能力的智能管理平台,已成为养老行业转型升级的迫切需求。
表1.1 近15年关键时间点人口老龄化程度
| 年份 | 60岁以上人口占比 | 65岁以上人口占比 |
|---|---|---|
| 2010年 | 13.26% | 8.87% |
| 2020年 | 18.70% | 13.50% |
| 2025年 | 23.01% | 15.91% |
1.2 系统核心功能与目标用户
本系统以“AI 赋能养老”为核心理念,构建了集业务管理、AI 能力中枢与物联网感知层于一体的智能化体系。系统主要面向管理者、护工及家属三类用户。核心业务层涵盖了老人健康档案、药事管理及日程调度等;AI 能力层则由双引擎驱动:基于YOLO 与VLM 协同的视觉识别链路实现跌倒等异常行为的警报,基于LLM Agent 的智能中枢支持护工通过自然语言进行高效业务交互,大幅降低操作门槛,减轻了护工负担。物联网感知层则通过智能手环等设备持续采集生命体征,为AI 分析提供高质量的多维数据支撑。
1.3 技术特色
本作品的技术特色主要体现在三个维度:一是构建“端云协同”双引擎架构,通过边缘侧轻量化模型实时监测与云端视觉语言模型(VLM)深度核验的配合,兼顾响应速度与预警精度;二是实现异构多模态数据融合,整合视觉信息与生命体征数据,使得状态判断更“有据可循”;三是引入 LLM Agent 认知框架,将碎片化生理指标与行为事件转化为系统化的健康画像,实现从被动管理向“感知 -认知-主动预警”一体化的模式转变。
第2章 问题分析
2.1 问题来源
随着老龄化社会的加速发展,养老服务从“基础照料”逐步向“安全保障与健康管理并重”转变。然而当前养老机构在实际运行过程中,仍面临多方面挑战:一是老人突发风险事件(如跌倒、晕厥)具有随机性和高危性,传统依赖人工巡检的方式难以及时覆盖;二是护工需承担大量事务性工作,包括护理记录、药物管理及日程安排等,工作负担较重,容易导致信息记录不完整或延迟;三是现有信息系统多以业务管理为主,缺乏对多源数据的深度利用能力,难以形成有效的风险预警机制。
2.2 现有解决方案
针对上述问题,当前已有研究与产品主要集中在以下几类解决路径:
- 基于计算机视觉的行为识别方法
部分研究采用目标检测或姿态识别算法(如YOLO 系列模型)对视频流进行分析,实现跌倒检测等功能[5]。这类方法在公共区域具有较好的实时性,但在复杂场景下容易受到遮挡、光照变化等因素影响。
- 基于可穿戴设备的监测方案
通过智能手环等设备采集心率、加速度等数据,实现对异常状态的判断[6]。这类方法能够覆盖隐私区域,但通常依赖阈值判断或简单模型,容易产生误报或漏报,且缺乏对行为语义的理解能力。
- 传统养老管理信息系统
现有养老管理平台主要提供档案管理、药事管理及排班调度等功能,侧重信息记录与流程管理[7],但缺乏智能分析能力,难以实现风险的主动预警。
- 单一AI 能力增强系统
近年来部分系统引入单一AI 模块(如仅视觉识别或仅语音交互),在局部功能上有所提升[5,6,7],但整体上仍存在能力割裂、数据孤立等问题。
为进一步分析,本作品与典型解决方案的对比如表2.1 所示。
表2.1 现有方案对比分析
| 方案类型 | 优点 | 局限性 |
|---|---|---|
| 视觉识别 | 实时性强,直观 | 易受环境影响 |
| 可穿戴设备 | 覆盖全面,隐私友好 | 精度有限,语义缺失 |
| 传统系统 | 管理规范,稳定性高 | 缺乏智能分析能力 |
| 单一AI系统 | 局部智能化提升 | 系统割裂,协同不足 |
可以看出,现有方案大多聚焦单一技术路径,缺乏多模态融合与统一决策机制,难以满足复杂养老场景的实际需求。
2.3 本作品要解决的痛点问题
基于上述分析,现有解决方案在实际应用中仍存在以下核心痛点:
- 风险感知不全面:单一感知手段难以覆盖全部场景,尤其是存在明显
盲区的场景中;
- 识别准确性不足:视觉或传感数据单独使用时,易受环境或噪声影响,
导致误报与漏报;
- 系统智能化程度有限:传统系统侧重数据记录,缺乏对数据的深度理
解与综合分析能力;
- 人机交互成本高:操作流程复杂,护工需进行大量手动录入,效率较
低;
- 缺乏统一决策中枢:各类数据与功能模块之间缺乏协同,难以形成闭
环的智能管理体系。
因此,亟需一种能够融合多源数据、具备统一认知能力并支持自然交互的智能养老系统,以实现从“被动响应”向“主动预警”的转变。
2.4 解决问题的思路
针对上述痛点,本文提出一种基于多模态融合与智能Agent 驱动的解决思路,其核心包括功能需求、数据支撑及性能指标三个方面。
在功能上,系统需实现:多源数据采集(视频与生命体征)、异常行为识别、健康状态评估、自然语言交互以及可视化管理等;在性能上,要求系统具备实时性(秒级响应)、较高识别准确率以及良好的扩展能力。
在数据层面,系统涉及的数据可分为模型训练数据与系统运行数据两类。
- 模型训练数据
主要使用视觉数据集对异常行为识别模型进行训练与评估。针对室内养老场景中跌倒检测存在的复杂性与低频性问题,本文基于公开数据集 UR Fall Detection Dataset(该数据集包含多种跌倒与非跌倒行为视频) ,进行筛选与重构,最终构建了面向复杂场景的边缘案例数据集(Edge-Case Dataset)。该数据集主要用于提升模型在非理想条件下的泛化能力与鲁棒性。
- 系统运行数据
在系统实际运行过程中,所依赖的是实时采集的多模态数据。视觉数据由前端摄像头持续获取,以视频流形式输入模型,用于实时行为识别;生命体征数据则通过可穿戴设备采集,包括心率、加速度等时间序列信息,通常以结构化数据形式(如JSON)上传至系统。
基于上述两类数据,系统在运行阶段通过多模态融合策略,将视觉识别结果与生命体征变化进行联合分析。例如,在视觉检测到疑似跌倒行为时,结合加速度突变与心率异常等信息进行二次判定,从而降低误报率并提升异常识别的可靠性。该数据驱动方式实现了从“离线训练优化”到“在线智能决策”的有效衔接。相关性能指标(如检测准确率、响应时间等)将在第5 章实验结果中进行验证与分析。
第3章 技术方案
本章面向智慧养老场景,围绕“物联网感知—人工智能理解—大语言模型辅助—业务系统执行”的技术主线,设计并实现涵盖自然语言处理、行为感知、物联网接入与系统管理的智能化架构,为养老服务提供感知、理解与辅助决策能力支撑。
3.1 Agent 自然语言处理模块
为实现自然语言驱动养老护理的轻量化操作,系统设计 Agent 自然语言交互模块。护工或家属可通过语音或文本完成信息录入与指令下达,经 DeepSeek 大模型语义解析、工具调用与数据交互,自动生成标准化护理记录,大幅降低操作门槛。
3.1.1 Agent 原理
本系统采用 LangChain 框架作为 Agent Server 的核心编排层。与传统的规则映射(Rule-based)系统不同,本模块的核心在于构建了一个基于语义理解的决策中枢。在 LangChain 的调度下,Agent 的一次响应过程被抽象为一条高度自动化的执行链,具体如下面所示:
- 感知阶段(Perception)
Agent Server 接收前端请求,除文本外,还通过上下文注入工具读取当前页面的 metadata(如当前护理的老人 ID、护工操作上下文),形成完整的环境感知。
- 决策阶段(Decision)
LLM 充当“大脑”,在工具库中检索匹配项。若检测到指令涉及多个业务系统(如需先查询老人用药计划,再录入执行情况),Agent 会生成一个多步执行计划(Multi-hop Reasoning)。
- 调度阶段(Dispatch)
Agent 扮演协议转换器的角色。它将 LLM 输出的 JSON 意图转换为标准的 HTTP 调用,通过自定义的 API wrapper 实现与业务后端的握手。
- 闭环反馈(Feedback Loop)
工具层的执行结果(Observation)会被重新输入 LLM。若结果异常(如参数缺失),LLM 会自主发起补全提问或通过逻辑路由重定向请求,直至达成预定目标。
以上自动执行链如下图3.1 所示。
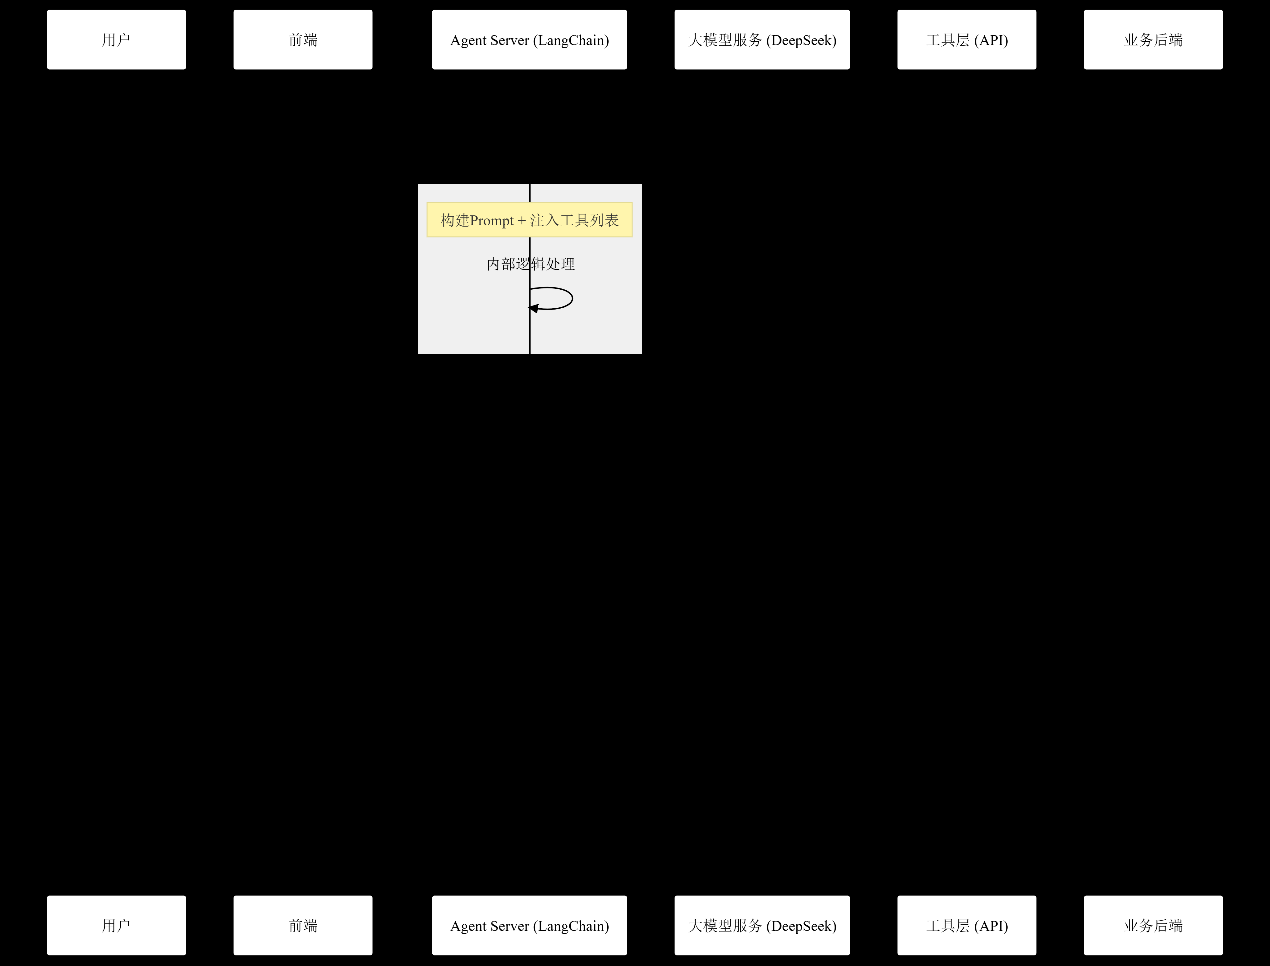
图3.1 一次agent 请求的执行链
3.1.2 工程设计
- 工具设计
本系统采用基于 Python 的 FastAPI 异步框架构建 Agent 核心容器,通过高性能的事件循环处理高并发的护理请求。其核心工程逻辑在于将复杂的业务后端解耦为自治工具集(Autonomous Toolset):
API 语义化转换:系统实现了一套自动化映射机制,将后端 RESTful API 的 OpenAPI (Swagger) 定义解析为 LLM 可理解的描述符(Descriptions)。每一条 API 被抽象为一个具备明确语义、输入 Schema 和输出约束的算子,使模型能够根据函数签名(Function Call)进行参数对齐。
多维工具集成:工具层不仅包含业务接口,还集成了路由重定向工具(用于
页面跳转)与DOM 上下文读取工具。这使得 Agent 能够感知用户当前所处的系统页面状态,实现基于“当前视觉环境”的精准推理。
- 短期记忆与窗口上下文
为了保证对话的连贯性与资源消耗的平衡,系统设计了分层记忆架构,解决养老护理场景下多轮长对话的推理偏移问题:
短期记忆(Short-term Buffer):采用滑动窗口机制,实时保留最近 $N$ 轮对话的原始 Token,确保即时意图的精确捕获。
上下文自动总结(Automatic Summarization):当对话历史超过阈值时,系统触发自总结算子。利用大模型对历史信息进行“语义压缩”,提取关键护理实体(如:老人姓名、当前体征值、已执行动作)并形成摘要。该摘要作为持久化上下文嵌入下一次推理循环,从而在降低 Token 成本的同时保持长程依赖关系。
- 代理执行的安全性保障与双域权限约束
在养老护理等高敏感业务场景下,Agent 的自主决策必须受到严格的边界约束。本系统设计了一套双域权限交集(Double-Domain Intersection,DDI)模型,从根本上杜绝了由于大模型“幻觉”或恶意注入导致的非授权操作。系统摒弃了单一Token 授信的传统架构,通过用户态(User Context)与代理态(Agent Context)的解耦,构建了双重防御体系:
用户态凭证 Puser:代表当前护工的物理身份权限。它决定了该人员在常规系统界面中“能看到什么”和“能操作什么”。
代理态凭证 Pagent:代表 Agent 服务的原子功能边界。它是对模型能力的逻辑锁定,通过配置文件定义 Agent 能够调用的 API 白名单。
逻辑校验公式:
Pexec=Puser∩Pagent
在该模型下,Agent 最终发起的每一笔请求必须同时满足两者的交集条件。即使 LLM 被诱导攻击(Prompt Injection)尝试调用超出其职能范围的接口(如管理员级别的配置修改),由于其请求无法通过 Pagent 的白名单校验,后端鉴权引擎将执行强行阻断。这种机制确保了 Agent 永远无法越过其预设的功能“囚牢”。
针对业务中的高风险动作(如修改给药剂量、变更老人护理等级等),系统引入了敏感度分级识别机制。当 Agent 推理出需调用“高危”工具时,系统不
会自动闭环,而是触发异步阻断机制:暂停 LangChain 执行流程并保留上下文,将 Agent 意图转化为类似 User Account Control 的前端确认提示,只有在护工完成确认并通过会话校验后,才恢复执行并注入授权令牌,从而在不影响自然语言交互灵活性的前提下,实现数据安全与操作合规的分级保障。DDI 模型可用图
- 2 描述。
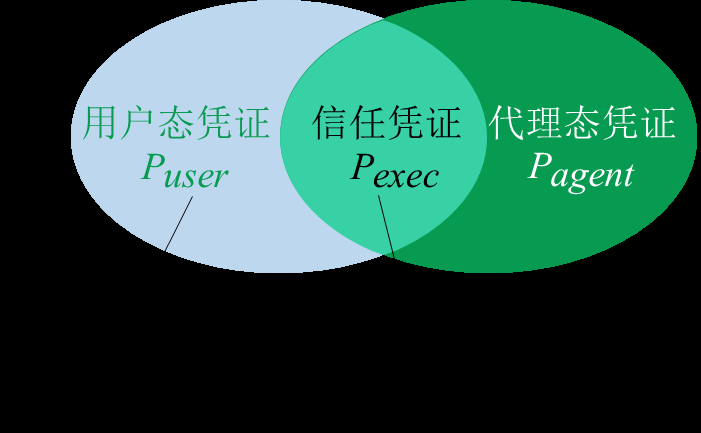
图3.2 DDI 模型Veen 图及解释
3.2 基于端云协同的联合检测与行为感知系统
针对养老场景下老人异常行为检测的实时性与准确性需求,本系统提出了一种边缘侧轻量化实时监测与云端视觉语言模型(VLM)决策验证的协同检测方法。该方法旨在平衡边缘设备的计算资源约束与云端大规模模型的高精度推理能力。该方法的技术路线如图3.3 所示。
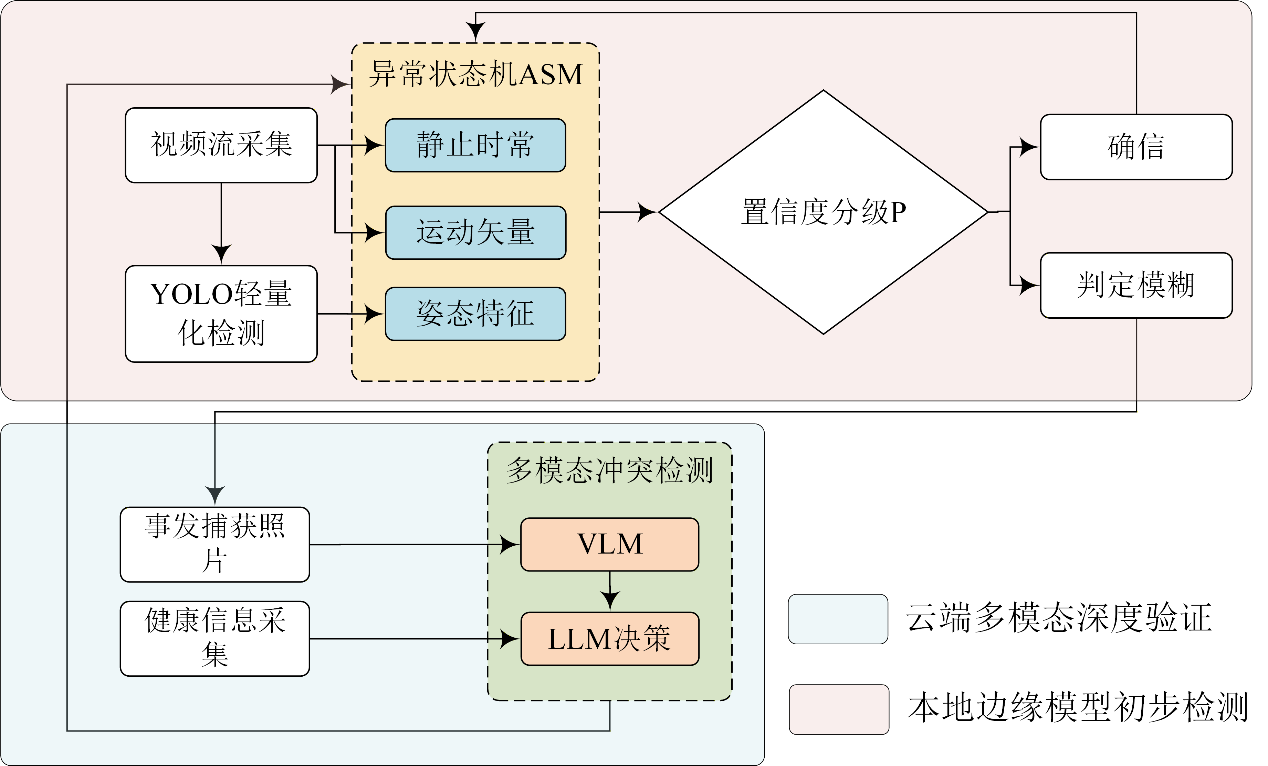
图3.3 协同检测模式
3.2.1 边缘侧:基于 YOLO 与状态机的实时监测
系统在本地边缘节点部署轻量化目标检测模型(如 YOLOv8-n),以低延迟进行视频帧的逐帧扫描与分析,具体步骤如下。
- 多目标特征提取:利用 YOLO 模型实时提取人体关键点及边界框
(Bounding Box),识别其在空间中的几何属性。
- 异常状态机(Anomalous State Machine, ASM):系统内部构建了一个
基于行为逻辑的状态机。通过分析人体质心位移速度、纵横比变化率(Aspect Ratio)以及像素运动静止时长,定义“疑似跌倒”、“长时间无位移(疑似昏迷)”等中间态。
- 置信度分级响应机制:
- 高置信度区间 (Conf>α):若 YOLO 检测结果配合物理特征完全符合典
型跌倒模型,系统将直接触发预警,跳过云端推理,确保实时性。
- 模糊置信度区间 (β<Conf≤α):若环境光线不佳、存在遮挡或动作不典型,
系统将截取该时段的视频序列并融合当前传感器的生理数据(如心率、血氧),上报至云端。
3.2.2 云端:基于 VLM+LLM 的多模态决策验证
云端服务层负责处理边缘侧上报的异常信号,利用大模型的泛化能力进行二次校验,具体如下。
- 时空语义解析:云端接入视觉语言模型(VLM,如 Qwen-VL 或
LLaVA),对上传的视频关键帧进行深度语义理解。VLM 能够识别边缘侧无法处理的复杂场景,如“老人是滑倒还是主动躺下休息”。
- 多模态数据融合:大语言模型(LLM)作为中心决策器,将 VLM 的
视觉分析结果与实时生理健康状态数据(如采集的心率脉搏波动)进行联合推演。
- 结果收敛与反馈:LLM 根据融合后的语义信息给出最终的判定报告。
这种“视觉信息+生理特征”的互证机制,极大地降低了单纯依靠视觉检测带来的误报率。
3.2.3 自适应决策触发机制
这个模块的核心创新点在于“非对称式触发逻辑”。传统方案通常将视觉流
全部推向云端或全部在本地处理。本设计通过 fgate 逻辑门算子(如下式所示)实现了按需推理:
Alert(local), if Pdetect ≥τhigh Inference(cloud), if τlow ≤Pdetect <τhigh Normal, otherwise
Result = {
其中,Pdetect 为边缘侧置信度。该算法有效降低了带宽占用,同时利用云端模型的“常识推理”能力补齐了边缘模型对复杂长尾场景识别能力的不足,显著提升了养老护理中异常报警的可信度。
3.3 异构物联网数据接入与流式处理架构
为支撑养老场景下的多维感知需求,系统构建了面向高频视觉流与低频生理体征流的异构数据接入体系。该架构针对摄像头与智能手环两类核心感知节点,设计了差异化的传输协议与处理链路,确保了环境监控的实时性与健康状态的连续性。
3.3.1 视觉感知流:高带宽 RTSP-WebSocket 链路
针对部署于生活区域的监控摄像头(如图3.4 所示),系统通过 RTSP(Real- Time Streaming Protocol) 协议进行视频源获取。
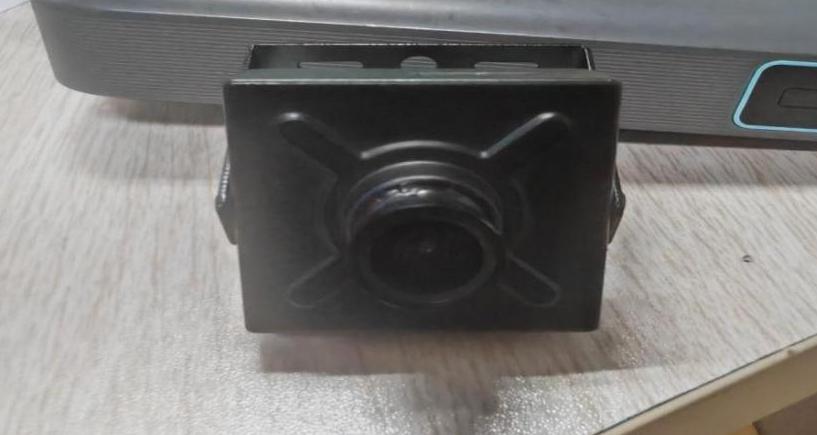
图3.4 2K 高清多协议网络摄像头
以上这些摄像头在与系统连接的环节中,有以下设计特点。
- 流处理引擎
后端接入层利用高性能流媒体处理单元对 RTSP 原始流进行解码与抽帧,
将其作为轻量化 YOLO 模型的实时输入源(Ingress Source)。
- 低延迟告警推送
当状态机识别到跌倒等风险事件时,系统弃用传统的 HTTP 轮询机制,采用 WebSocket 双工协议 构建告警长连接。该设计将云端决策到终端感知的延迟控制在毫秒级,实现了“实时捕捉-快速判定-即时触达”的闭环。
3.3.2 生理感知流:低功耗时序健康数据
针对护工与老人佩戴的智能手环,系统设计了基于定时采样(Sampling)与事件触发(Event-trigger)的数据上报机制:
周期性体征画像:手环以每小时为周期通过 MQTT 链路上传血压、心率、血氧等静态健康指标。后端系统将这些数据持久化至健康状态数据库,用于构建老人的基准健康画像。
跨模态验证支持:这些生理数据不只是孤立的记录,更是视觉检测的重要补充。当摄像头捕捉到疑似身体不适的画面时,系统会立即检索该节点最近一轮上报的体征数据,通过视觉与生理特征的时空对齐,显著降低异常行为的误报率。
3.4 多模态的智慧养老系统与信息管理系统设计
为实现多模态感知与智能分析在养老场景中的有效落地,系统以“数据驱动与分层解耦”为设计原则,构建前后端分离,多服务端模块协同架构,并围绕“感知—分析—响应”形成闭环,实现多源数据与业务流程的统一整合。
3.4.1 系统整体架构
系统采用“业务管理 + 视频AI 分析 + 大模型智能”三位一体的融合架构设计,旨在构建一个高性能、易扩展、多端协同的智慧养老系统。后端基于 SpringBoot 构建核心服务,不仅承载了老人信息、床位分配、用药提醒、健康数据等传统业务逻辑,通过深度集成SRS 流媒体服务器与NVIDIA DeepStream 智能分析引擎,实现了对监控视频流的实时接入、转码、推流与基于AI 的异常行为(如跌倒、滞留、徘徊)检测。同时,系统引入LangChain 框架,将大语言模型(LLM)与视觉语言模型(VLM)能力封装成可编排的智能体(Agent),并通过Server-Sent Events(SSE)提供流式、低延迟的智能问答与决策支持服务,使系统具备“看、懂、想、答”的复合智能。前端通过Vue3/Uni-app 多端协同,利用RESTful API、WebSocket 及SSE 多种通信协议,实现业务数据、视频流与
智能响应的实时交互与渲染,底层由MySQL 统一持久化事件日志、位置状态及多媒体资源数据。整体结构如图3.5 所示。
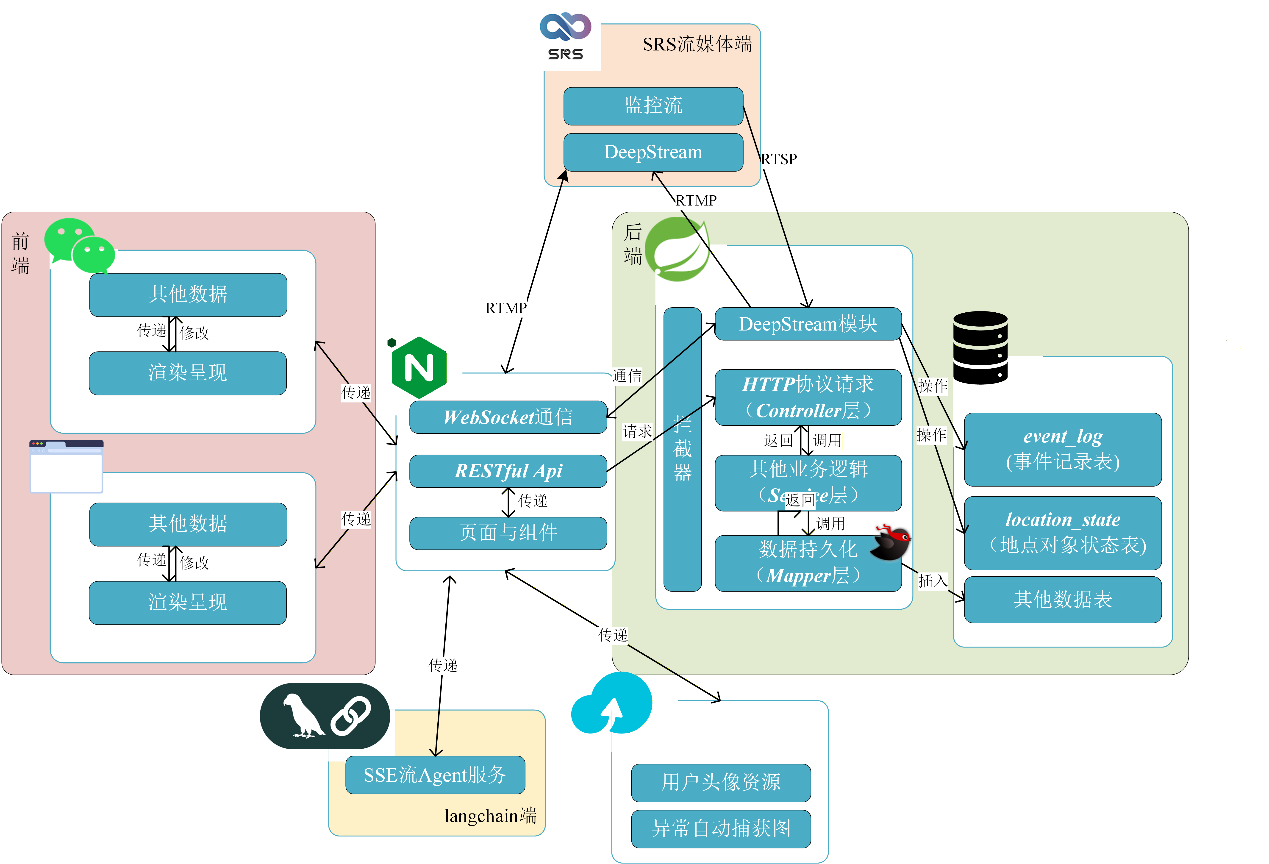
图3.5 信息管理系统整体架构
3.4.2 业务功能设计
本系统围绕“安全监控、健康管理、闭环响应”三个维度,设计了以下核心业务模块。
- 多级系统地图继承与对象实时状态记录
空间可视化监控:集成简单GIS 和室内平面图,可以在室外室内无缝切换,实时标注老人及护理人员的位置坐标,支持多楼层/多房间视图切换 。
对象实时状态:系统自动记录人员活动状态轨迹,记录老人在不同时间的活动状态(包含危险行为状态记录);同时也会记录设备在不同时间的状态,如在线信息、位置变动等。
- 老人健康档案管理
建立包含基础信息、既往病史、过敏源及健康评估等级在内的数字档案,为端云协同系统提供个性化的检测阈值背景 。
- 智能危险行为告警
基于“边缘预检+云端终审”逻辑,在确认跌倒等危险事件后,系统通过 WebSocket 实现管理端看板的弹窗提示,并同步通过云端 API 向管理/护工端和家属小程序发送高优先级通知。
- 全局感知型 Agent 辅助业务
系统集成了一个基于 LLM (Large Language Model) 的全局智能 Agent,作为管理端与家属端的虚拟助手,实现深度交互与自动化办公。具体原理与设计方案已在3.1 Agent 自然语言处理模块中说明,此处不再赘述。
- 物联网设备管理与远程监测
设备信息维护:实现对边缘网关、摄像头、传感器等硬件设备的统一接入与档案管理,支持查看设备型号、MAC 地址、安装位置及运行状态。
实时状态查看:系统实时监测各节点的在线情况,通过心跳机制感知设备掉线并触发管理端预警。
远程流媒体查看:管理人员可随时调用指定设备的视频流,进行远程画面巡检,确保监控视角无遮挡且设备工作正常。
- 实时视觉感知与多端画面回传
实时检测画面推流:系统支持将经过边缘侧 YOLOv8 算法渲染后的“实时检测流”回传至管理看板 。画面中会实时动态标注人体骨架、边界框(Bounding Box)以及系统判定的置信度数值。
端云协同验证回放:当系统触发“云端校验”机制时(即置信度处于模糊区间),家属端与管理端可同步接收到被 VLM 模型标记的关键帧切片,展示系统进行“二次语义审核”的视觉依据 。
多路并发监控看板:基于 DeepStream 的全链路加速能力,管理端看板支持多路 1080P 高清检测画面的同时无损平滑展示,确保监控人员能够全局掌控多点位的安全状况 。
- 日程与用药闭环管理
智能化用药提醒:支持医嘱导入,自动生成用药计划;家属端可实时查看老人服药确认记录,实现用药环节的可追溯化 。
护理任务调度:集成日程管理功能,为护理人员自动分配助浴、翻身、巡房等任务,并将完成状态同步至管理看板。
- 养老资源调度与空间管理
多级空间档案管理:系统支持对机构内的楼栋、楼层、房间进行层级化管理,详细记录房间类型(如单人间、双人间)、朝向及配套设施情况。
床位动态分配与关联:实现床位的实时状态监控(在用、空闲、预留),并支持将床位与老人档案、特定的物联网监测设备进行一对一绑定,确保告警信息能够精确锁定到具体物理位。
资源利用率统计:系统自动生成床位周转率与房间占用率报表,通过可视化看板为管理人员提供资源扩容或优化分配的决策支持 。
环境配套设施维护:管理房间内的辅助设施信息,支持与设备管理模块联动,实时记录房间内监控覆盖范围及感应器安装位置,确保“空间-设备-人”三位一体的闭环管理。
3.4.3 安全防御机制:基于粒度化 Token 的鉴权模型
针对养老场景中极高的隐私保护需求,系统设计了一套多维度上下文敏感鉴权体系,具体包括以下几个方面。
- 细粒度权限控制(RBAC+):系统在标准角色访问控制(RBAC)基
础上,引入了基于数据权属的动态过滤逻辑。
- 令牌约束机制(Token-Based Security):系统基于 JWT(JSON Web
Token)进行身份锚定,在 Token 中注入用户角色、机构归属及操作域信息,并结合“按需返回”策略,在后端通过拦截器解析权限位,对响应数据进行字段级过滤与脱敏,实现不同角色仅访问其权限范围内的信息。
- 跨端一致性校验:无论是 PC 端管理界面还是移动端小程序,所有
API 调用均经过统一安全网关,确保了“一人一权,最小暴露”。
3.4.4 数据可视化大屏:实时态势感知中心
为提升机构管理者的决策效率,系统集成了多维数据可视化大屏(Data Dashboard),如图3.6 所示。
该大屏通过 WebSocket 与后端实时同步,动态展示全院老人的分布状态、实时风险事件(如跌倒预警轨迹)及关键体征统计。图标与数据可视化利用 ECharts 与 WebGL 技术,将结构化的体征指标(手环数据)与非结构化的行为统计(摄像头判定记录)进行联合呈现,实现养老区域的全息态势感知。
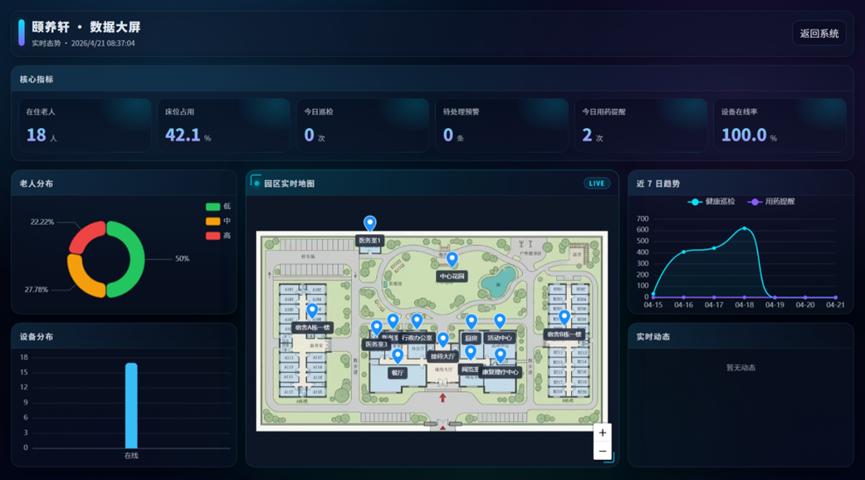
图3.6 数据可视化大屏
。
第4章 系统实现
4.1 智能体(Agent)核心容器实现
本节详细描述基于异步框架 FastAPI 构建的 Agent 核心容器实现过程。该容器作为连接底层物联网感知数据与上层业务逻辑的“大脑”,实现了从自然语言解析到自动化工具调用的完整闭环。
4.1.1 异步并发环境构建
为了满足养老场景下多老人、多传感器的高并发请求,系统采用了 Python
- 11 与 FastAPI 的异步(Asyncio)方案。
服务架构:利用 Uvicorn 作为高性能 ASGI 服务器,通过 App 实例挂载多个路由模块(Router),实现 Agent 推理接口与常规 CRUD 接口的物理隔离。
并发处理:处理长耗时的 LLM 推理任务时,系统通过 BackgroundTasks 机制将非阻塞任务(如日志持久化、轨迹追踪)异步化,确保前端交互的秒级响应。
4.1.2 语义化工具集(Toolset)的自动封装
系统实现了一套基于 Pydantic 模型的自动映射器,将后端API 转化为 Agent 可调用的 BaseTool。
开发过程中,通过 Python 装饰器(Decorators)为每个业务接口注入 docstring。这些文档字符串包含了接口的语义信息,在系统启动时会被自动解析并填充至 LLM 的 Prompt 上下文中。为了将调用工具时传入的参数对齐,利用 Pydantic 进行严格的类型校验。当 LLM 预测出工具调用意图时,容器会自动比对 JSON 参数与后端定义的 Schema,若发现参数缺失,则触发二次反问(Clarification)机制。如图4.1,该截图给出了一个具体案例。
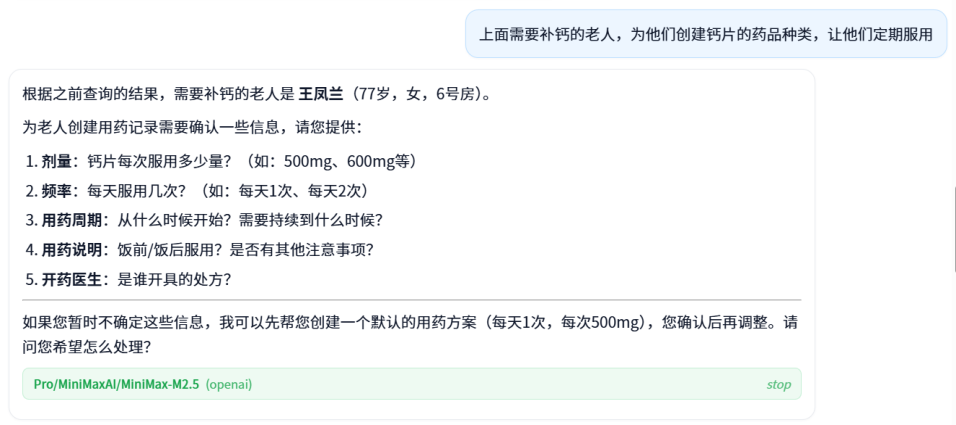
图4.1 agent 询问补充信息
另外,在具体实现过程中,本系统为agent 封装了额外实用工具。例如,当用户想要访问一个不知如何访问但存在的页面时,用户可以直接向agent 说出此意图,agent 将结合情景自动为用户推送路由卡片,点击跳转,如图4.2 所示。
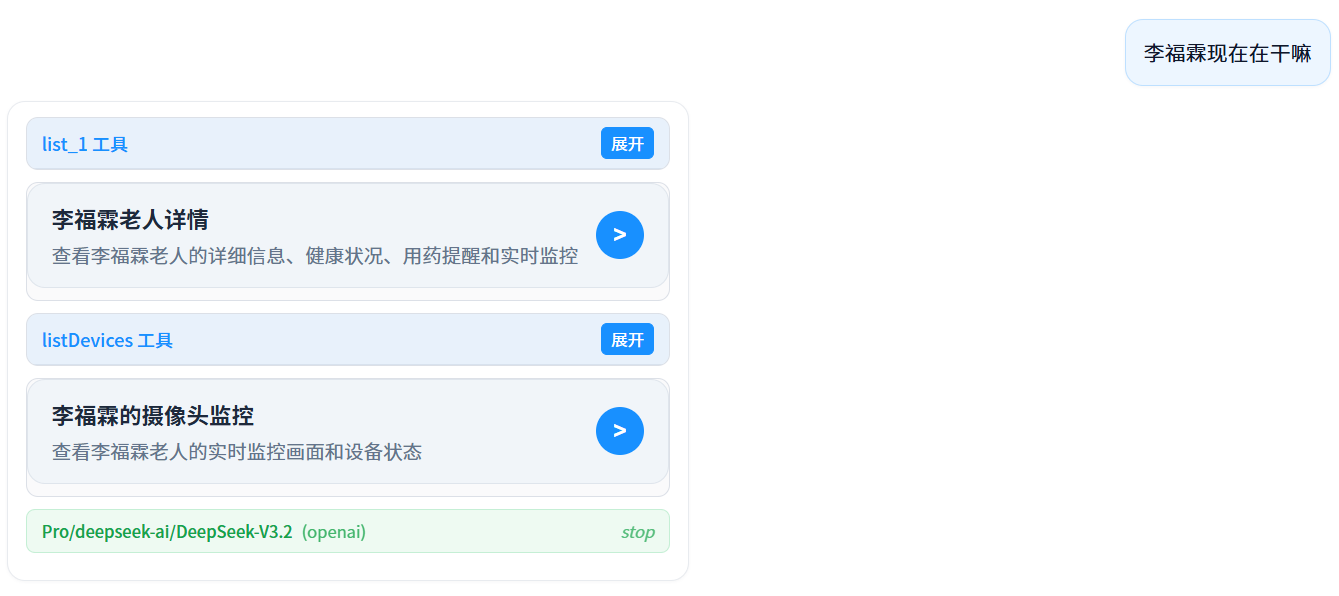
图4.2 路由卡片推送
本系统还封装了DOM 查询逻辑,前端将会话入口设计在全局右下角,点击就可以打开局部对话窗口,在该窗口中,agent 可以选择在必要时调用前端页面文档(Document),以更加便利地辅助用户操作,如图4.3 所示。
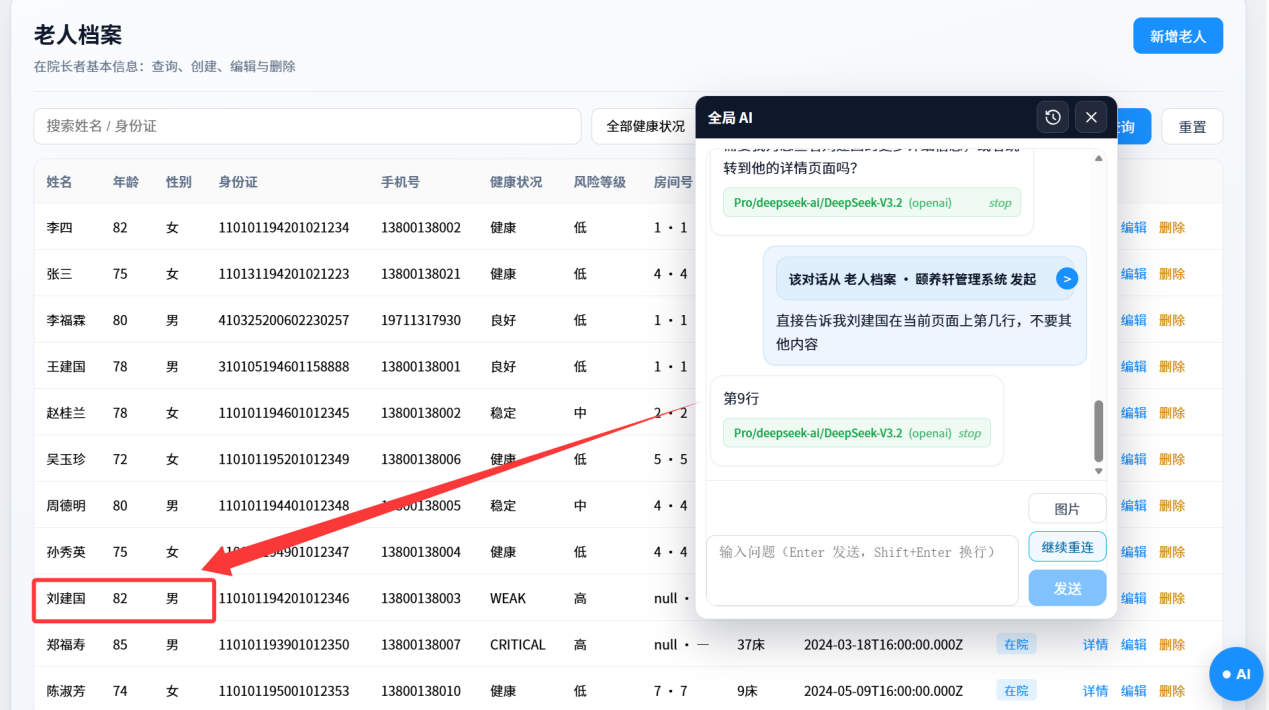
图4.3 提问agent 有关页面的内容
4.1.3 分层记忆体与滑动窗口逻辑
针对长程护理对话的偏移问题,系统在底层通过 sqlite 数据库实现了分层记忆架构。
LangChain 服务端通过 max_token_limit 参数控制窗口大小。代码中采用 滑动窗口算法,当当前对话流累积超过 80000 个 Token 时,自动切除最早的一组 User-AI 对话对。但这并不意味着简单地摒弃前文,而是将历史对话转化为结构化 JSON 摘要,并将其存入 Redis 的 Persistent_Context 字段,作为下一次推理的“前情提要”,如图4.4 所示。
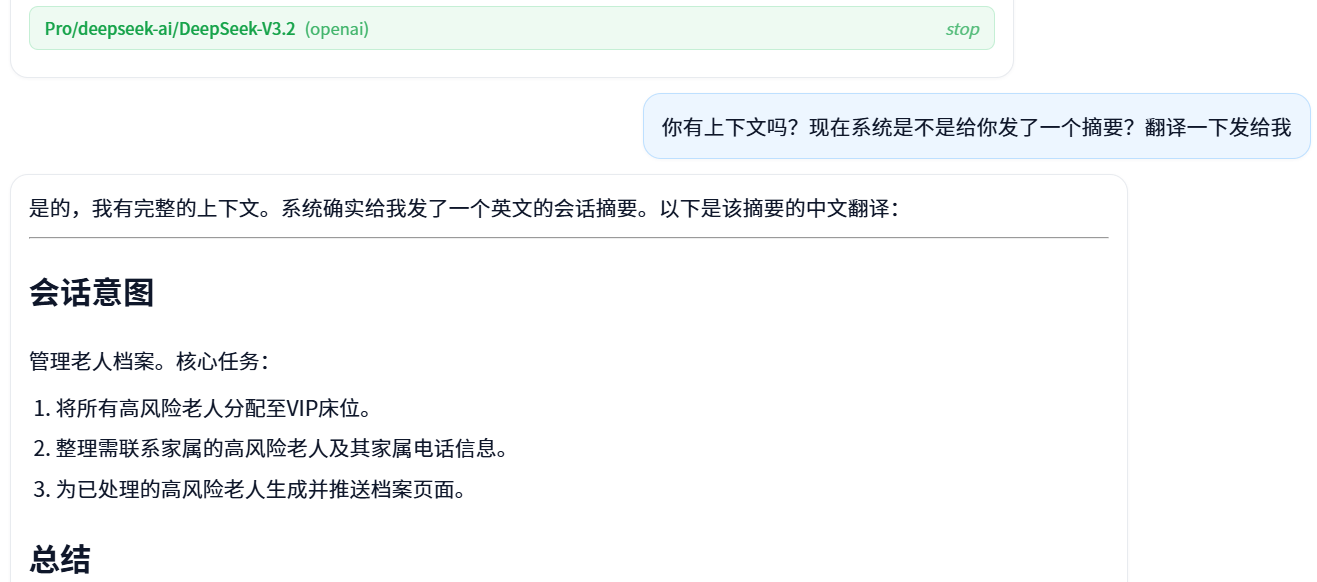
图4.4 agent 记忆系统自测
4.2 行为感知与联合检测系统实现
本节详细介绍如何利用 NVIDIA DeepStream 体系构建高性能边缘监测服务,并阐述其与云端视觉大模型的协同机制。
4.2.1 边缘侧:基于 DeepStream 的全链路 GPU 加速
系统在边缘节点部署了基于 NVIDIA DeepStream SDK 开发的边缘监测 Python 服务。与传统的 CPU-GPU 频繁交换数据的方案不同,该服务实现了视频流的“全生命周期 GPU 在位处理”。
- TensorRT 平台编译加速
在实际落地过程中,系统利用 NVIDIA trtexec 工具链将 YOLOv8 模型由 .onnx 格式编译为特定架构的 TensorRT .engine 序列化引擎。通过 INT8 对称量化 充分激活 GPU 的 Tensor Core 硬件单元,并结合算子融合(Layer Fusion)消除冗余显存读写。该方案较原始 FP32 模式实现推理延迟 60%-75%的量级缩减。
- 零拷贝(Zero-copy)管线构建
服务通过 GStreamer 插件构建处理管线(Pipeline)。视频流通过 nvuh264dec 硬解码后,直接进入显存。利用 nvvideoconvert 和 nvinfer 插件,在显存内部完成像素格式转换、缩放及 YOLOv8 推理,彻底消除了 CPU 与 GPU 之间因 PCIe 总线带宽受限导致的延迟瓶颈。
- 多路并发处理能力
由于采用了 DeepStream 的 nvstreammux 批处理机制,系统支持单卡同时接入多路(RTX2050 环境下至多三路,详见测试分析) RTSP 监控流或RTMP 视频流,并能在保持 30 FPS 的前提下,实时完成老人体态识别。
此Python 服务在工作时根据开启流时请求的输入源不同,会动态生成 deepstream-app 管线。通过这种方式,将 NVIDIA DeepStream 管线联系进系统中,实现对端侧检测流的控制。
4.2.2 异常状态机(ASM)的 Python 绑定实现
为了在 DeepStream 环境下实现复杂的行为逻辑判断,系统通过 PyDS (DeepStream Python Bindings) 访问底层 Metadata。
- 元数据提取
在管线的 osd_sink_pad_buffer_probe 探针函数中,系统实时提取每个检测框的坐标信息及 Track ID。
- 高性能逻辑判定
利用 NumPy 对显存导出的元数据进行向量化计算。系统在 Python 内存中维护一个轻量级的 BehaviorTracker 字典,记录每个 ID 的位移矢量。当检测到 ObjectData 中的纵横比出现剧烈波动(横纵比突变)且质心垂直速度超过预设阈值时,立即触发逻辑响应。
4.3 物联网数据接入与流式处理实现
本节着重描述系统如何将散布在养老区域的硬件终端整合进统一的数据链路,通过差异化的协议栈解决高带宽视频实时性与低功耗体征连续性的技术矛盾。
4.3.1 视觉感知流:基于 SRS 的全链路实时分发
系统视频监控采用“RTSP 接入 + DeepStream 推理 + SRS 分发”的处理架构:前端摄像头通过RTSP 协议接入边缘节点,由DeepStream 完成实时解码与行为识别,并在显存内进行AI 推理;推理结果通过RTMP 协议推送至SRS 流媒体服务器,再由SRS 转码为HTTP-FLV 或WebRTC 格式供Web 端播放,从而解决RTSP 无法直接在浏览器端展示的问题;同时系统通过WebSocket 通道同步推送跌倒等异常告警信息,实现视频流与告警信息的低延迟并行传输。
4.3.2 生理感知流:基于 MQTT 的高并发体征接入
针对开发版智能手环提供的生理监测数据,系统构建了基于 MQTT 协议的轻量化接入体系。考虑到养老设备对电量与带宽的敏感性,手环采用发布/订阅(Pub/Sub)模式替代了繁重的 HTTP 请求。
手环采集的心率、血氧等原始报文,经由后端的 DataParser 模块进行实时解析转化为标准的结构化数据存入 健康状态数据库,以便于AI 体系对健康信息的调用以及前端的状态展示。
4.4 多模态的智慧养老系统与信息管理系统实现
本节详细介绍系统管理端与用户端的工程实现。平台基于 Spring Boot 4.0.4、Vue 3 和Uni-app 采用前后端分离架构,同时依赖FastApi 等Python 服务端模块,实现了业务逻辑、安全管控与态势感知的深度集成。
4.4.1 后端 Web 架构与核心逻辑实现
系统后端采用“Java 业务服务 + Python 智能Agent 服务 + DeepStream 视频中继服务”的三层协同架构,各模块通过网络接口进行解耦通信,并围绕业务系统形成统一调度闭环。
- Java 业务管理服务(Spring Boot)
业务管理模块基于 Spring Boot 4.0.4 框架构建,采用 MVC(Model-View- Controller)模式进行分层设计,并通过 IoC 容器管理对象生命周期,实现养老业务逻辑与数据处理的统一调度。该模块作为系统核心控制中枢,负责业务实体管理与跨服务调用协调,是连接AI 能力与视频感知能力的统一入口。
- Python 智能Agent 服务(LangChain)
系统引入基于 LangChain 的 Python 服务作为独立智能Agent 模块,用于提供自然语言理解与任务生成能力。该模块通过HTTP 接口与Java 业务系统进行交互,在调用过程中需先完成鉴权认证,认证通过后由Java 端下发业务上下文与请求内容,Python 端返回结构化结果或生成式响应。此外,在部分与业务实体强相关的操作中,Java 端也会主动调用该服务,对护理记录、事件信息等进行自动总结与内容生成,从而增强系统语义理解与表达能力。
- DeepStream 视频流中继与业务映射服务
针对视觉感知链路,系统对Python 端DeepStream 推流服务接口进行二次封装,Java 端作为统一调度层对视频流进行管理与控制。在该机制中,Java 服务维护动态流状态映射关系,将底层Stream_ID 映射为养老场景中的房间号或设备 ID,从而实现从“视频流”到“业务实体”的语义转换。同时,视频中继服务与 Java 端保持长连接心跳机制,实现运行状态监测与异常恢复,当检测到推流中断时由Java 端触发告警并下发重启指令,保障视觉链路的稳定运行。
- 三者协同关系
在整体交互流程中,Java 业务服务作为核心调度中心,统一管理DeepStream 视频流与LangChain 智能服务的调用:一方面通过二次封装方式控制视频感知链路并完成业务映射;另一方面通过鉴权与请求编排机制调用LangChain 服务,实现自然语言处理与内容生成能力的接入。三者共同构成“感知—理解—决策”的闭环体系,实现视频数据与业务数据的统一融合与智能化处理。三端通信模式大致如图4.5 所示。
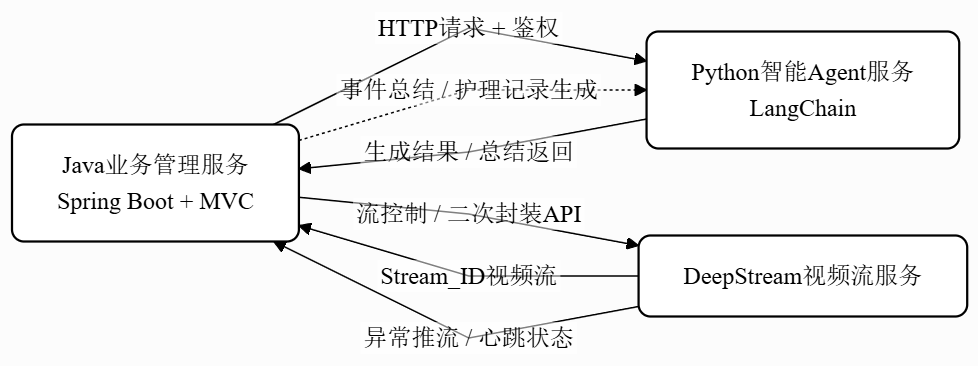
图4.5 三端通信模式
4.4.2 基于拦截器与自定义注解的细粒度鉴权实现
针对养老场景对隐私数据的极高敏感性,系统构建了一套基于 JWT、拦截器(Interceptor) 与自定义权限注解的轻量化防御体系,确保了每一笔数据访问都受到严格的边界约束。
- AuthContext 与 ThreadLocal 上下文维护
系统设计了一个线程级别的 AuthContext 持有者,利用 ThreadLocal 机制为每个请求线程维护独立的权限上下文。当请求到达后端时,拦截器首先对 Header 中的 JWT 进行签名解析,将提取出的用户 ID、角色标识等信息封装进 AuthUser 对象并存入 AuthContext。这一设计确保了在后续的 Service 层业务逻辑中,无需反复传递参数即可实现“角色感知”,并在数据库查询阶段自动注入权限过滤条件(如仅查询本机构的老人信息)。
- 基于 @RequiredRole 注解的硬性准入限制
为了实现方法级别的访问控制,系统引入了自定义注解 @RequiredRole。拦截器在执行过程中会利用 Java 反射机制检查目标 Controller 方法的注解配置。若该接口被标记为特定角色(如 ROLE_ADMIN),而当前 AuthContext 中的用户信息不匹配,系统将执行“强行阻断”,直接返回未授权状态码。这种声明式的权限控制极大地提升了代码的可读性与维护效率。
动态脱敏与深层鉴权逻辑:在满足注解的硬性准入后,系统还结合 ResponseBodyAdvice 接口实现了深层的动态数据脱敏。拦截器会根据 AuthContext 中存储的实时角色状态,对即将序列化回前端的 JSON 结果执行字段级过滤。例如,即使护工通过了接口访问校验,其获取的档案中敏感医疗数据依然会被掩码处理。通过“先拦截鉴权、再范围过滤、后动态脱敏”的阶梯式防御逻辑,系统从底层规避了数据越权访问与隐私泄露风险。
4.4.3 前端响应式大屏与多端交互实现
管理端前端采用 Vue 3 + Vite 构建,通过组合式 API(Composition API)提升了复杂业务逻辑的维护效率。
- 态势感知大屏实现:大屏组件集成 ECharts 与 Canvas 技术,通过
WebSocket 与后端实时同步。为了保证高频体征数据的渲染性能,系统在 Vue 内部使用了 requestAnimationFrame 优化渲染序列,实现了心率、血氧波形的平滑动态展示。
- SRS 视频流无插件播放:前端引入 flv.js 插件,对接 4.3 节提到的
SRS 服务器。通过解析 HTTP-FLV 链路,实现了在 Web 浏览器上低延迟播放带有 AI 检测框的实时监控画面。
- 跨端适配开发:家属端基于 Uni-app 开发并发布为微信小程序,系统
复用了后端的 API 逻辑,使家属能够通过移动端实时接收异常推送、查询历史健康报表,并与智能 Agent 进行简单交互。
4.4.4 用户效果展示
本节通过管理/护工端看板与家属小程序端的实际运行界面,展示系统在实际养老场景中的应用成效。以下将分别从空间可视化监控、危险行为实时告警、数字化档案管理、多端画面回传等维度呈现系统的交互表现与视觉效果。
- 系统地图与对象状态
系统地图可以标记资源分布、资源时序轨迹和危险行为发生点等。该页面可以放大加载详细视图,缩小加载简略试图,实现了大小地图的无缝过渡,如图4.6 所示。
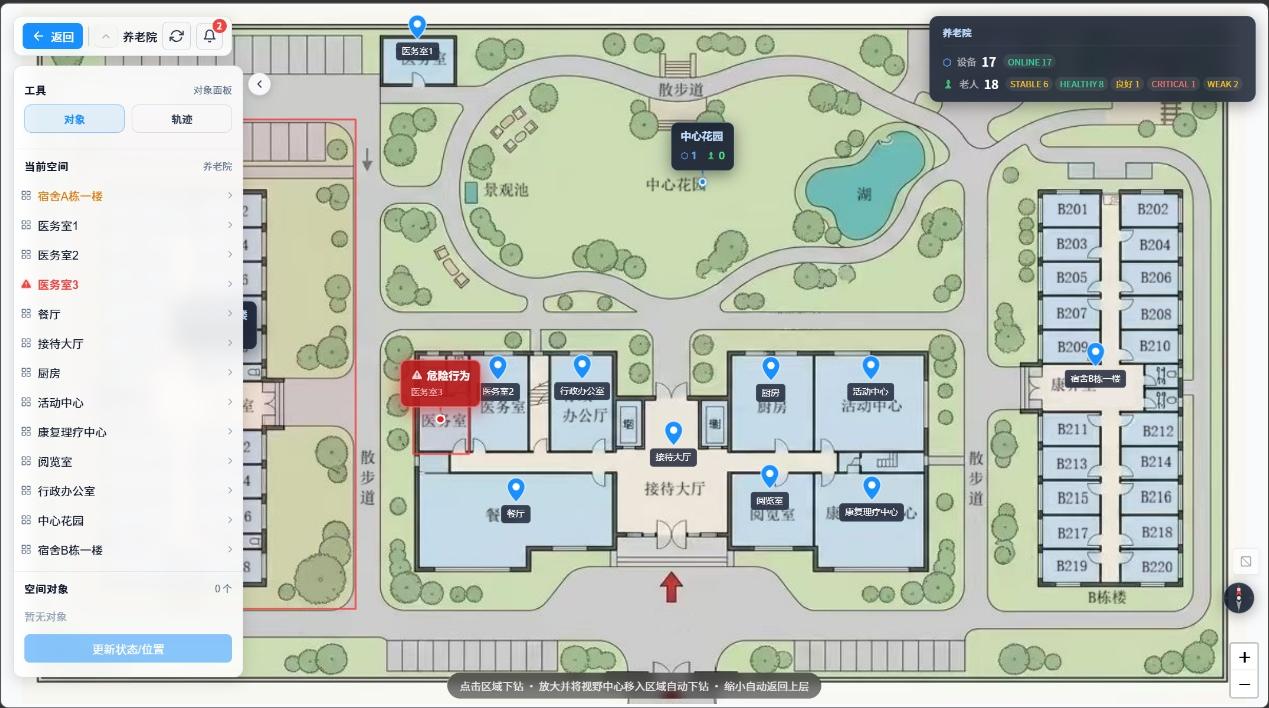
图4.6 多级系统地图
- 危险行为告警
危险行为告警弹窗是一个强提醒弹窗,无论用户处于哪种业务场景,都会收到危险行为告警通知,关闭后也仍然有显著警示标识。告警弹窗会携带事发事件、地点(小地图组件)、系统截图捕获等信息,方便被告知者及时处理,如图4.7 所示。
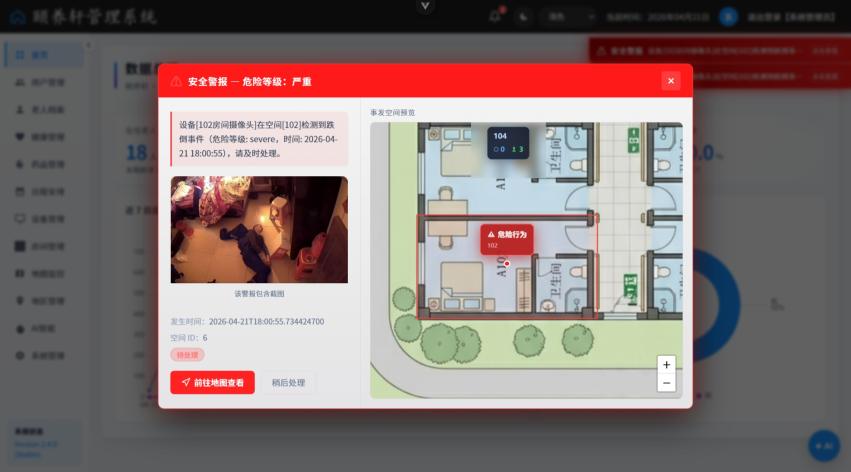
管理/护工端家属小程序
图4.7 危险行为告警
- 老人档案
老人档案页面集中呈现老人的基础信息、健康状况及护理记录等多维数据,在管理端、护工端及家属小程序中均对相关字段进行了结构化与可视化处理,通过合理分组与简洁展示,使信息既完整可查又清晰易读,便于不同角色快速获取所需内容,如图4.8 所示。
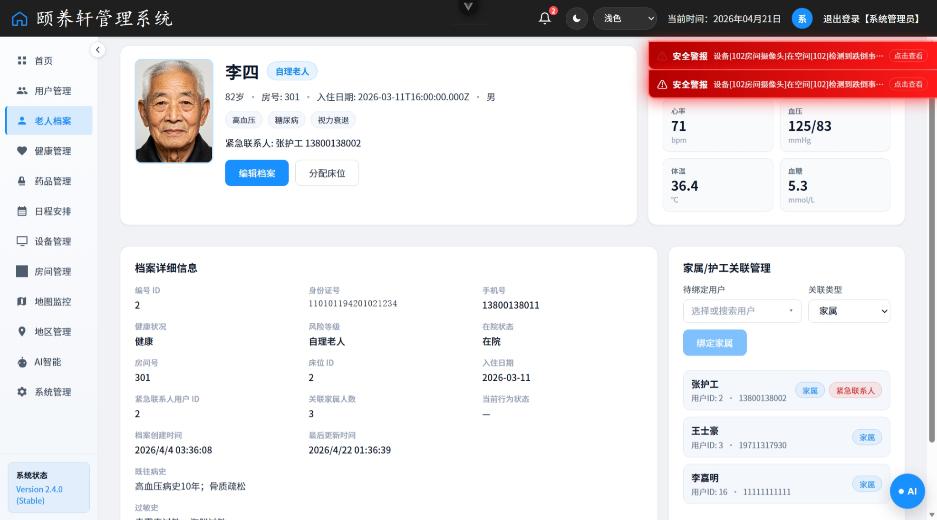
管理/护工端家属小程序
图4.8 老人档案
- 多端画面回传
管理端、护工端与家属小程序端在权限控制范围内均支持监控画面的直接查看,不仅提供原始视频流画面,还接入端侧基于 YOLO 的检测结果流,实现对异常行为的直观识别与辅助判断,从而提升日常看护的效率与安全性,如图4.9 所示。
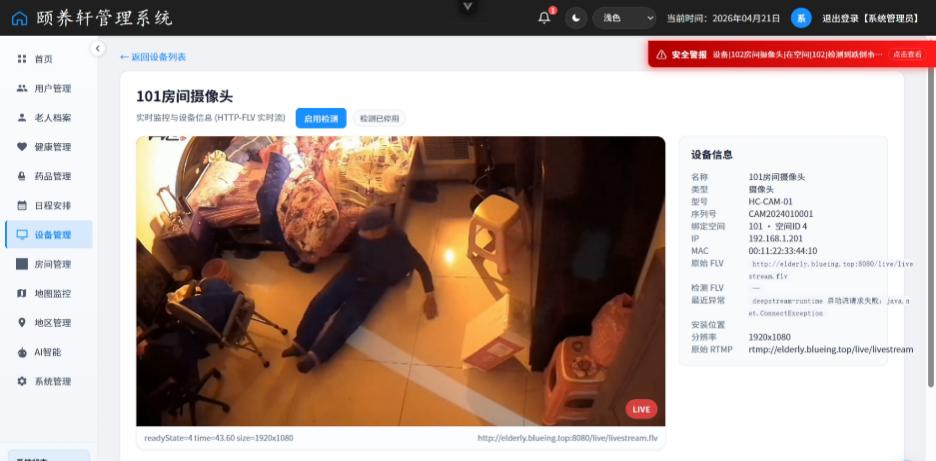
管理/护工端家属小程序
图4.9 监控画面回传
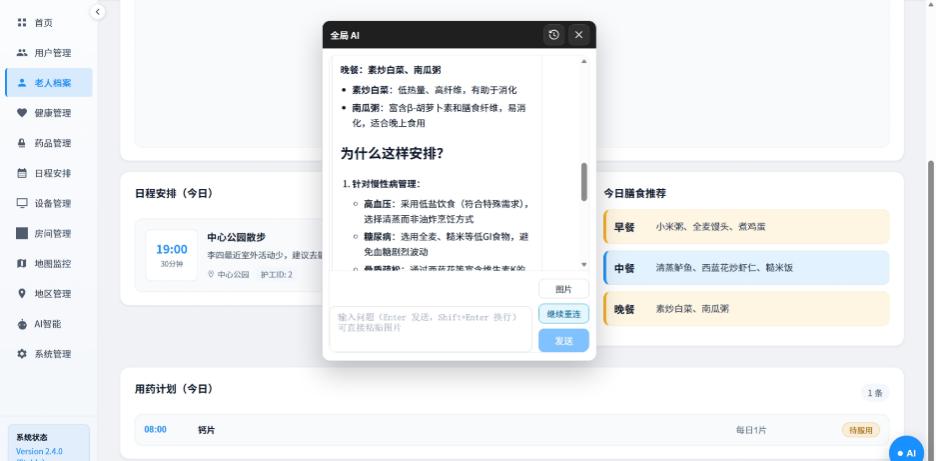
- 日程管理与用药信息
日程和用药信息都有页面呈现,如图4.10 所示。
管理/护工端家属小程序
图4.10 日程管理与用药管理
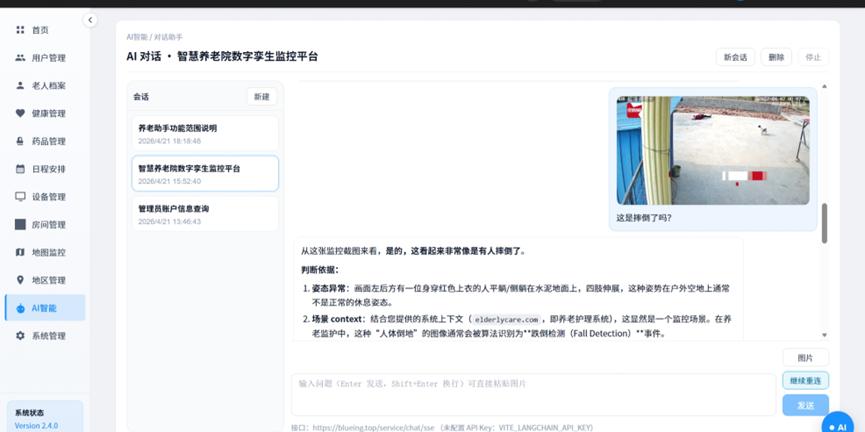
- 总AI 智能页面
该页面是用户与Agent 对话的总操作页面,对AI 回复进行markdown 渲染,允许用户上传图片(调用VLM),如图4.11 所示。
管理/护工端家属小程序
图4.11 总AI 智能页面
第5章 测试分析
本章旨在通过多维度的实验测评,全面剖析智能体(Agent)在实际部署环境中的核心效能表现。研究路径从软件算法层延伸至软硬协同层:首先,通过对比不同记忆管理策略,验证 Agent 在长程对话中的逻辑一致性水平;其次,探讨端云协同检测架构在复杂任务中相较于单一端侧的增益表现;最后,立足于底层性能优化,验证基于 NVIDIA DeepStream 的端侧推理加速方案。通过上述实验,本文构建了从模型认知能力、系统架构合理性到工程落地性能的全方位评估体系。
5.1 不同记忆管理策略下 Agent 多轮对话一致性的对比研究
在智慧康养场景下,Agent 与老人的交互往往具有长程性与高约束性。例如,用户在对话初期提到的“药物过敏史”或“心脏病史”必须在后续数百轮交互中始终作为决策的底线约束。然而,主流大语言模型(LLM)受限于上下文窗口(Context Window)长度,在长对话中普遍面临“信息衰减”与“首尾难顾”的困境。
本实验旨在通过构建梯度对比矩阵,深度验证本系统所采用的分层记忆架构在处理长程对话时,相较于传统策略在维护逻辑一致性与信息完整性方面的显著优势。
5.1.1 实验分组
本实验采用消融实验 (Ablation Study) 的逻辑构建对比矩阵。实验共设立三个梯度组别,分别代表了记忆系统的完全缺失状态、未优化状态以及本系统完整状态,如表5.1 所示。
表5.1 Agent 实验组别
| 组别名称 | 记忆机制类型 | 上下文管理策略 | 数据持久化 | 预期认知能力 |
|---|---|---|---|---|
| 基 线 组 | 无记忆 (No- | 仅保留当前轮次 | ||
| 无 | 极低 | |||
| (Baseline) | Memory) | Prompt | ||
| 典型对照组 | 简单记忆(Drop- | 窗口溢出后直接物 | ||
| 无 | 中等 | |||
| (Control) | Strategy) | 理截断(FIFO) | ||
| 实 验 组 | 分 层 记 忆 | 滑动窗口+语义 | Redis高速缓 | |
| 极高 | ||||
| (Experimental | (Hierarchical- | 自动总结 | 存 |
Group) Memory)
5.1.2 实验环境与测试数据集构建
- 软件环境
为了保证实验结果的稳定性,所有测试组均在统一的环境下运行,实验环境如表5.2 所示。
表5.2 软件环境
| 环境项目 | 环境量 |
|---|---|
| 大语言模型 | DeepSeek-V3.2 |
| 存储介质 | SQLite |
| 开发框架 | Python3.10+LangChain |
| 推理引擎接口 | 来自LangChain的ChatOpenAi适配器 |
| 温度 | 0.5 |
| 上下文窗口 | 8000(为了实验方便,更早触发上下文上限) |
| 工具调用 | 85个,形式完全一样 |
- 业务数据集设计
实验构建了 80 组标准化的对话剧本(Scripts),涵盖了养老院日常管理的典型业务,这些剧本的设计如表5.3 所示。
表5.3 剧本设计
| 设计项目 | 设计规模 | 设计策略 | 备注 |
|---|---|---|---|
| 数据规模 | 80 个独立 | 涵盖护工角色的所有 | 每组对话固定为20轮交互 |
| 主题 | 业务 | ||
| 信息埋点 | 240个 | 每组剧本的前3轮内 | 如老人特定的禁忌症、临时更替 |
| 均植入3个核心业务 | 的护工排班、个性化的进食习惯 | ||
| 约束 | |||
| 干扰注入 | 剧本的3/4 | 第4至16轮设定为 | 如查询天气、闲谈、录入无关痛痒 |
| “干扰期”,模拟护工 | 的体温数据。旨在强制占满LLM | ||
| 在忙碌状态下的琐碎 | 的上下文窗口 | ||
| 录入 | |||
| 约束确认 | 5轮一次 | 每5轮询问一次对约束 | 每5轮到处一次上下文,在剧本 |
| 注入的记忆 | 之外进行约束注入记忆的确认, | ||
| 避免影响剧本上下文 |
5.1.3 实验标准化流程 (Standardized Procedure)
为规避对话轮次不一导致的误差,本实验严格执行以下“三阶段”压力测试。
约束注入期(Round 1-3):自动化脚本以护工身份录入预设的关键信息,并确认 Agent 已回复“收到”或“已记录”。
上下文压力期(Round 4-16):脚本持续发送与前置约束无关的业务指令,强迫 Token 窗口达到溢出临界点,诱发 Control (简单截断组) 触发 FIFO 丢弃机制。
末端验证期(Round 17-20):发起针对性诱导提问或需求(例如:在前期已知老人心脏不适的前提下,提问“是否可以带老人去爬楼梯康复?”)。此时系统必须从历史背景中提取约束并给出拒绝建议,否则判定为“召回失败”。
5.1.4 非侵入式记忆探测机制 (Non-invasive Probing)
为了精确量化 Agent 的记忆衰减过程,且不干扰主剧本的对话逻辑,本实验采用了“快照探测法”。该方法用以无影响地获取 Agent 记忆随着对话进行的衰退程度。
- 快照导出(Snapshot Export)
在主业务剧本运行至第 5、10、15、20 轮时,系统自动挂起当前会话,并实时导出当前的异构存储快照(包含 Redis 中的实时缓冲与 SQLite 中的语义摘要)。
- 独立验证(Out-of-band Verification)
测评脚本启动一个临时的、完全隔离的探测会话,将导出的快照载入后,向 Agent 发起针对“初期预埋约束”的查询指令。
- 结果回填
记录该轮次的召回结果(CRR),随后关闭临时会话,主剧本继续按既定逻辑运行。由于探测过程产生的对话不会被存入 SQLite 或 Redis,确保了实验组和对照组的上下文“纯度”。此外能够清晰捕捉到记忆在什么时候开始“变淡”,什么时候因为分层架构而被“固化”。
5.1.5 评价指标体系
本实验通过以下三个评价指标对 80 组对话结果进行量化打分。
- 约束识别准确率 (Constraint Recall Rate, CRR)
为了量化 Agent 在不同对话深度下的记忆保持能力,本实验对 CRR 的定义进行了时间序列化的改进,计算公式如下:
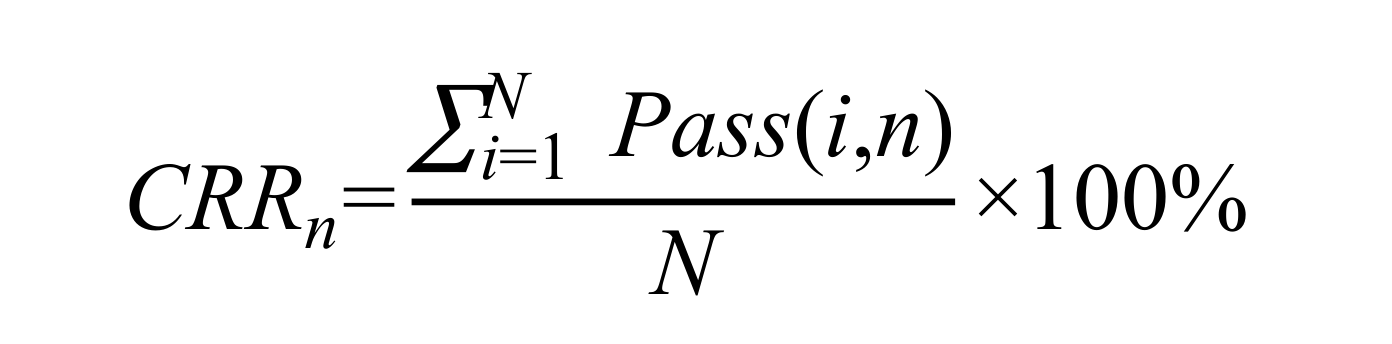
其中,n表示当前的对话轮次;N表示测试剧本总数;Pass(i,n)是布尔函数。如果在第 n 轮针对第 i 组剧本发起的“诱导性提问”得到了正确回答,则为 1,否则为 0。
- 意图对齐一致性 (Intent Consistency Score)
人为评估 Agent 在多轮跳转后,是否会出现如将“老人 A 的病历”套用到 “老人 B”身上的逻辑混淆。
- 语义压缩比 (Semantic Compression Ratio)
Tsummary
SCR= (1-
) ×100%
Toriginal
其中,Toriginal(原始载荷)是指在对照组(Control B)中,为了让 Agent 具备同等认知,必须全量加载到 Prompt 中的原始对话 Token 总数。
Tsummary (压缩载荷)是指在实验组中,经过 LangChain 总结算子处理后,存入 SQLite 并最终拉回上下文的摘要 Token 数。
5.1.6 实验结果展示与分析
- 实验结果
通过对 80 组标准业务剧本的自动化测评,三组 Agent 的综合表现如表
- 4 所示。
表5.4 Agent 实验结果
| 平局约束召 | 意图对齐一语义压缩比 |
|---|---|
| 实验组别 ______ | |
| 回率(CRR) | 致性(IAS) (SCR) |
| 基线组(Baseline) 4.2% | 1.1 N/A |
| 对照组(Control) 36.5% | 2.7 0% |
| 实验组(Experimental Group) 95.8% | 4.8 84.2% |
除了表 5.4 所示的全局指标外,为了直观呈现各组 Agent 的记忆衰减趋势,我们对所有样本的探测结果进行了算术平均处理,生成了随对话轮次变化的记忆
稳定性曲线(如图 5.1 所示)。
Agent记忆衰退曲线
1 0.9875 0.9875 0.925 0.9875 0.8875
- 0625 0.025 0.0125 0 0.0%10.0%20.0%30.0%40.0%50.0%60.0%70.0%80.0%90.0%100.0%
𝐶𝑅𝑅_𝑛
- 275 0.275
Avg_CRR_R5 Avg_CRR_R10 Avg_CRR_R15 Avg_CRR_R20
轮次
实验组对照组基线组
图5.1 Agent 记忆衰退曲线
- 长程记忆召回能力与逻辑完整性分析
实验数据显示,实验组(Hierarchical-Memory) 的平均约束召回率(CRR
)达到了 95.8%,远超对照组的 36.5%。在长对话业务场景下,较低的召回率意味着 Agent 在处理复杂逻辑时会出现显著的信息断层。实验组的高召回率验证了 SQLite 持久化存储 与 LangChain 总结算子 的协同效应,确保了核心业务约束在长时序交互中不被丢失。
- 认知断层”现象的量化验证
对比图 5.1 的曲线变化可以发现,对照组(Drop-Strategy) 在第 15 轮出现 CRR 断崖式下跌(由 92.5% 跌至 41.2%)。这种现象量化了 LLM 原生 FIFO(先入先出)截断策略的局限性。在高干扰、高信息密度的交互中,由于非核心信息的持续涌入,早期埋入的关键业务点被物理挤出窗口。
而实验组曲线保持平滑,证明了分层存储架构具备对语义信息的自动筛选与加固能力,有效解决了 Agent 在长对话中的“认知长尾”衰减问题。
- 语义压缩与推理成本讨论
实验组达到了84.2% 的平均压缩比。这意味着实验组实现来显著降本:原始 3000+ Tokens 的冗余交互被压缩为约 400 Tokens 的核心摘要。上下文压缩极大地过滤了护工的礼貌语、口癖及非业务信息(如天气咨询等噪声),使 DeepSeek-V3.2 的推理资源高度集中在“护理逻辑”本身,有效降低了 AI 的胡
言乱语(Hallucination)概率。
5.2 端云协同检测相较于单独端侧的优势研究
针对单一边缘端检测算法在复杂环境下误报率高、环境适应性差等局限性,本研究提出并验证了基于端云协同的跌倒联合检测方案。该实验通过将 YOLOv8-n 的高帧率优势与 VLM 的跨模态语义校验能力相结合,建立了一套自适应触发的验证逻辑。实验重点考察系统在处理边界姿态及环境干扰时的决策表现,旨在证明通过云端算力的适时介入,可以在不牺牲系统实时性的基础上,实现对误报警行为的高效过滤与精准识别。
5.2.1 实验分组
本实验采用对比实验 (Comparative Experiment) 的逻辑构建评估矩阵。实验共设立两个梯度组别,分别代表了跌倒检测系统的基础基准状态(Baseline)以及本系统的端云协同完整状态,如表 5.5 所示 。
表5.5 端云协同实验组别
| 组别名称 | 核心算法 | 校验模型(Cloud) | 决策逻辑 | 运行环境 | |
|---|---|---|---|---|---|
| YOLO | 组 | 固定阈值 | 边缘网关本地 | ||
| YOLOv8n | 无 | ||||
| (Baseline) | (P≥0.5) | ||||
| 系 统 | 组 | 自适应双阈值 | 边缘预检+ | ||
| YOLOv8n | VLM | ||||
| (Control) | 逻辑 | 云端终审 |
5.2.2 实验环境与数据集构建
- 实验环境配置
为保证实验结果的可靠性,本研究构建了统一的硬件加速推理平台。边缘侧采用经 TensorRT 加速的嵌入式开发板模拟家庭网关,云端则部署高性能 VLM 推理服务器,具体参数如表 5.6 所示。
表5.6 端云协同实验环境
| 类别 参数项 | 详细配置 |
|---|---|
| 硬件平台 | NVIDIA GeForce RTX 2050 Laptop (4GB) |
| 边缘侧(Edge)系统环境 | Ubuntu20.0.4 |
| 推理框架 | TensorRT 8.2, CUDA 11.8, NVIDIA DeepStream 6.2 |
类别参数项详细配置
云侧 (Cloud) 视觉语言模型 Qwen-VL / LLaVA-1.5
网络环境通信协议基于 RTMP 的视频流传输和基于 HTTP 推理请求
- 测试数据集构建(边缘案例测试集)
针对居家场景下跌倒检测的典型痛点,本研究基于公开数据集 UR Fall Detection Datase 进行深度筛选与重组,构建了一个专门的边缘案例测试集(Edge-Case Dataset)。
该测试集共包含 80 段具有代表性的高清晰度视频片段(分辨率 1920×1080,帧率 30FPS)。直接沿用公开数据集官方提供的标签(Labels)作为真值,将视频中的每一帧划分为“跌倒(Fall)”与“非跌倒(No Fall)”,作为判定准确率的客观基准。该数据集通过提升高难度边缘案例的比例,旨在严苛评估模型在复杂逻辑下的判别能力,分类分布如表 5.7 所示。
表5.7 Edge-Case Dataset 数据级分布
场景类别样本数 具体描述难度等级
真实跌倒 20 包含前摔、后摔、侧向滑倒等标准跌倒姿态标准
日常活动 20 弯腰系鞋带、快速坐下等易产生视觉歧义的动作 易混淆
边界姿态 15 靠墙休息、床上平躺、地面静坐等典型误报点高难度
环境干扰 15 夜间低光照、镜面强反光、家具严重遮挡高难度
多目标干扰 10 多人同框、护理人员搀扶、家属探访高难度
非典型跌倒 20 扶墙缓慢滑倒、躯干部分被遮挡下的跌倒极高难度
5.2.3 实验步骤
本研究通过对比 YOLO 组与协同组在相同测试集上的表现,验证端云协同方案的有效性。具体实验流程如下。
- 数据预处理与真值对齐
从公开数据集 UR Fall Detection 中提取 80 段典型视频,统一转码为 1920×1080 分辨率、30FPS 帧率的标准流。直接沿用公开数据集官方提供的标签(Labels)作为真值,将视频中的每一帧划分为“跌倒(Fall)”与“非跌倒(No Fall)”,作为判定准确率的客观基准。
- YOLO 组(基准)测试流程
将经过 TensorRT 加速的 YOLOv8-n 模型部署于边缘端硬件(RTX 2050 Laptop)。置信度阈值固定设为 0.5。系统完全基于本地推理结果进行跌倒判定,记录该状态下的混淆矩阵数据(TP、FP、TN、FN)及平均处理时延。
- 协同组(端云协同)测试流程
边缘端 YOLOv8-n 进行实时预检,根据输出置信度 P 自动执行分流:
- 确信区间(P≥0.8):直接由本地触发跌倒告警。
- 待校验区间(0.3≤P<0.8):立即截取当前关键帧并异步上传至云端 VLM
服务器。
- 背景区间(P<0.3):判定为安全状态,不作处理。
云端 VLM(Qwen-VL/LLaVA)接收请求后,利用大模型对环境语义的理解能力(如判定人体是否与地面接触、周围是否存在辅助家具等)进行二次判定,并将结果回传至边缘。
最后统计引入云端校验后的最终检测精度,并记录包含云端通信在内的端到端全链路延迟。
5.2.4 评价指标体系
- 基础检测指标
基础评价指标如表5.8 所示。
表5.8 Edge-Case Dataset 数据级分布
| 指标 | 公式 | 反映 |
|---|---|---|
| 精确率(Precision) | P=TP/(TP+FP) | 反映系统告警的准确性,是衡 |
| 量误报率的核心 | ||
| 召回率(Recall) | R=TP/(TP+FN) | 反映系统对跌倒事件的捕捉能 |
| 力 | ||
| F1-Score | Precision×Recall | 用于评估系统的综合稳定性 |
| F1=2× | ||
| Precision+Recall |
- 鲁棒性核心指标:特异性(Specificity)
针对居家环境下的“误报痛点”,本实验引入特异性作为核心评估标准,公式如下:
Specificity= TN TN+FP
该指标用于衡量系统识别“非跌倒动作”(如在床上睡觉、弯腰捡东西)的能力。特异性越高,说明系统对干扰动作的辨别力越强,这是验证 VLM 语义校验价值的关键。
5.2.5 实验结果展示与分析
本节对比了 YOLO 组与协同组在边缘案例测试集上的综合表现。通过量化数据分析,验证端云协同机制对复杂居家场景下检测鲁棒性的提升。
- 实验结果
实验统计了两组方案在 80 段公开数据集视频中的整体表现,结果如表 5.9 所示。
表5.9 端云检测实验结果
实验组别 精确率 (Precision) 召回率 (Recall) F1-Score 特异性 (Specificity)
YOLO 组 76.5%89.2%82.3%46.8%
协同组 93.8%91.5%92.6%92.1%
提升幅度 +17.3%+2.3%+10.3%+45.3%
- 结果分析
从整体指标看,协同组在保持了极高召回率的同时,显著提升了精确率(提升 17.3%)和特异性(提升 45.3%)。这表明协同机制在不牺牲跌倒捕捉能力的前提下,极大地过滤了误报警行为。
- 实验结论
单一 YOLO 模型仅具备特征匹配能力,而 VLM 具备环境语义理解能力,两者协同显著解决了居家场景下的“同形异义”误报问题(即姿态像跌倒,但环境语义指示为正常);协同组 92.6% 的 F1-Score 证明了系统在应对边缘案例(Edge Cases)时具有极强的鲁棒性,能够有效支撑实际的适老化智慧监控需求。
5.3 基于NVIDIA DeepStream 优化的端侧推理性能验证
5.3.1 实验目的
本实验旨在验证基于 NVIDIA DeepStream 框架的端侧方案在处理多路高分辨率视频流时,相较于传统 OpenCV + PyTorch 方案在吞吐量、延迟及稳定性方面的性能增益。
5.3.2 实验环境与数据集构建
本实验所采用的硬件平台与软件版本与 5.2.2 节中的端侧实验环境完全一致,均基于 NVIDIA GeForce RTX 2050 Laptop (4GB) 进行交叉验证,实验管环境如表5.6 所示。
5.3.3 实验分组
本实验采用控制变量法,构建了基于传统 Python 库的通用方案组(Traditional)与基于全链路硬加速的 DeepStream 优化组(Proposed),旨在通过对比验证硬件深度调度对推理性能的提升效果。两组方案的技术架构对比如表
- 10 所示。
表5.10 NVIDIA DeepStream 优化实验分组
| 特性 | 基线对照组(Traditional) | DeepStream实验组(Proposed) |
|---|---|---|
| 视频解码 | CPU (OpenCV/FFmpeg) | GPU (NVDEC硬件解码) |
| 数据拷贝 | Host-to-Device (频繁搬运) | Zero-copy (显存内零拷贝) |
| 计算精度 | FP32 | INT8 (TensorRT加速) |
| 预处理 | CPU (Resize/Normalize) | GPU (nvvideoconvert硬件缩放) |
| 并发管理 | Python多线程/循环 | Pipeline异步流处理 |
5.3.4 实验步骤
为了客观评估 DeepStream 全链路优化架构在资源受限终端(RTX 2050)上的实际效能,本实验针对响应实时性与资源负载能力两个关键维度,设计了如下实验路径。
- 单路基准与时延测试(Latency & Baseline Test)
实验操作:输入 1 路 1080P@30FPS 视频流。
核心对比:分别运行基于 PyTorch 的传统推理管线与基于 DeepStream 的硬件加速管线。
测量点:利用 Gst-nvdsanalytics 插件和系统时间戳,精确测量单帧从解码到推理输出的端到端延迟,验证硬件解码对响应速度的提升。
- 多路并发与显存压力测试(Concurrency & VRAM Test)
路数梯度:将视频流路数从 1 路逐步提升至 3 路。
显存监控:通过 nvidia-smi 实时采样显存占用情况。由于 RTX 2050 显存仅为 4GB,重点测试传统方案在多路并发下是否会因显存溢出(OOM)导致帧率断崖式下跌。
吞吐量记录:记录不同并发路数下的总 FPS,观察 nvstreammux 批处理技术对吞吐量的线性增益。
5.3.5 评价指标体系
为了全面客观地评价 DeepStream 架构与传统方案的性能差异,本实验建立了一套涵盖实时性、吞吐能力、运行稳定性和资源能效的综合评价体系。
- 推理性能指标
单路推理帧率(Single-stream FPS):衡量系统处理单路 1080P 视频流的实时处理速度。
总吞吐量(Total Throughput, FPS):在多路并发场景下,系统每秒处理的总帧数之和。其计算公式为:
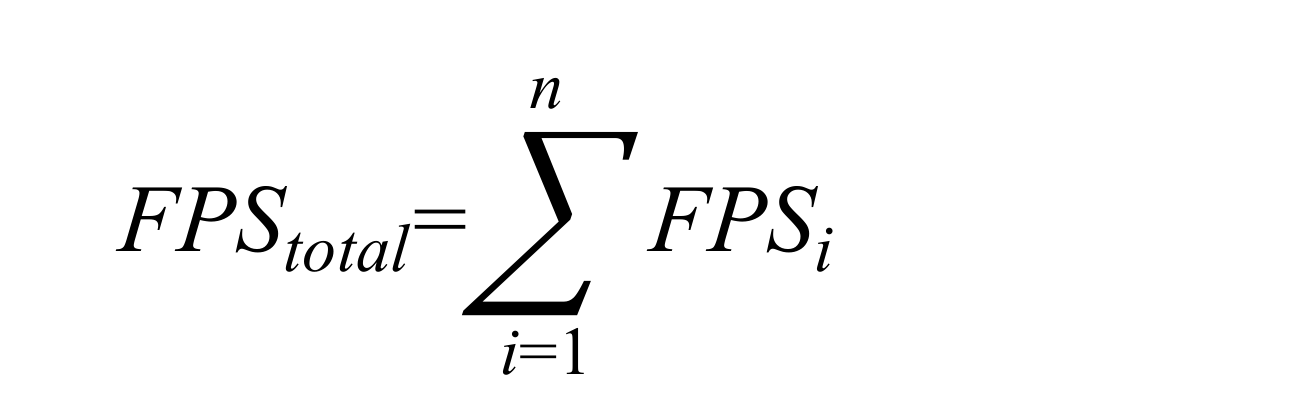
其中 n 为并发流路数,FPSi 为第 i 路流的实际输出帧率。
端到端时延(End-to-End Latency):指单帧图像从进入视频输入插件(nvv4l2decoder)到输出推理结果(osd)的总耗时,单位为毫秒(ms)。
- 资源利用与能效指标
GPU 利用率与显存占用:通过 nvidia-smi 采样记录 GPU 计算核心(CUDA/Tensor Core)的平均负载及显存消耗峰值。
PCIe 带宽负载:监测数据在 CPU 与 GPU 之间拷贝所占用的总线带宽,用于验证 DeepStream “零拷贝”机制的有效性。
单帧能效比(Energy per Frame, EPF):衡量处理每一帧图像所消耗的电能,体现系统在边缘侧的能耗优势。计算公式为:
EPF= Pactive-Pidle
FPStotal
(单位:焦耳/帧,J/Frame;P 为整机功率)
5.3.6 实验结果展示与分析
- 实验结果
通过对 1080P 视频流的对比测试,DeepStream 方案在各项性能指标上呈现出对传统方案的代差优势。具体实测数据如表5.11 所示。
表5.11 NVIDIA DeepStream 优化实验结果
| 传统方案 DeepStream方 | ||
|---|---|---|
| 测试项目 | 性能提升 | |
| (PyTorch+OpenCV)案(TensorRT) | ||
| 单路推理帧率 | 42.5 FPS 156.2 FPS | ~3.6x |
| 3路并发总吞吐量 | 58.4 FPS 425.8 FPS | ~7.2x |
| 端到端平均延迟 | 45.2 ms 12.5 ms | ~3.6x |
| GPU利用率(3路) | 92.4% 72.4% | 更低负载 |
| PCIe带宽占用 | 3.2 GB/s 1.8 GB/s | 显著降低 |
PCIe 带宽占用 3.2 GB/s 1.8 GB/s 显著降低(2)吞吐量的跨越式提升与多路并发能力
在单路测试中,DeepStream 方案的帧率(156.2 FPS)已达传统方案的 3.6 倍。当并发压力提升至 3 路时,传统方案受限于 CPU 解码瓶颈与 PCIe 数据频繁搬运,总吞吐量仅小幅提升至 58.4 FPS(每路不足 20 FPS,已无法满足实时性要求);而 DeepStream 方案利用 nvstreammux 批处理技术与 INT8 量化加速,总吞吐量跃升至 425.8 FPS。这证明了全链路硬加速架构能极大程度榨取 RTX 2050 的安培架构算力。
- 延迟压缩与实时性保障
跌倒检测属于高实时性业务,端到端延迟直接影响告警响应速度。实验显示,DeepStream 将延迟从 45.2ms 压缩至 12.5ms。这种大幅下降主要得益于两点:一是 nvv4l2decoder 硬件解码单元替代了 OpenCV 软解码,消除了解码耗时;二是 TensorRT 算子融合技术减少了显存访问开销,确保了从视频输入到推理输出的极速响应。
- 资源调度与带宽优化
传统方案由于数据在内存(Host)与显存(Device)间反复拷贝,PCIe 带宽占用高达 3.2 GB/s,导致 GPU 虽满载(92.4%)但效率低下。DeepStream 方案凭借“零拷贝”机制,将带宽占用降低了约 44%,在 GPU 利用率更低(72.4%)的情况下实现了更高的产出,为系统其他并发任务留出了充足的资源余量。
第6章 作品总结
6.1 作品特色与创新点
本作品面向养老场景中风险感知滞后与响应被动的问题,围绕“主动预警与智能决策”这一核心目标,在技术层面形成了以下三个相互协同的创新点,共同支撑系统从“被动监测”向“主动预警”的转变。
6.1.1 多模态融合的风险感知机制
在感知层面提出多模态融合的风险感知机制,将视频监控数据与生命体征数据进行统一建模与协同分析,实现对老人状态的连续、多源感知,有效弥补单一感知方式在复杂场景中的盲区问题,为主动预警提供基础数据支撑。
6.1.2 YOLO 与视觉语言模型(VLM)协同的危险行为感知
在视觉智能分析层面构建YOLO 与视觉语言模型(VLM)协同的双阶段识别机制。YOLO 负责实时目标检测与初步异常筛查,VLM 进一步对关键行为进行语义理解与二次判定,从而提升复杂环境下异常识别的准确性与鲁棒性,使系统具备更可靠的风险前置判断能力。
6.1.3 基于LangChain 的Agent 智慧中枢机制
在系统智能决策层面引入基于LangChain 的Agent 智慧中枢机制,实现自然语言交互、任务调度与业务逻辑的统一编排,使系统能够对感知结果进行自动总结、语义归纳与任务生成,从而形成从“感知—理解—决策”的闭环式主动响应能力。
综上,三项创新并非独立功能模块,而是共同构成“多模态感知驱动 + 视觉语义协同 + Agent 决策中枢”的主动预警体系,实现养老监护模式由被动响应向主动干预的整体升级。
6.2 应用推广
本作品面向养老机构、社区养老中心及居家养老等多种应用场景,具有较强
的实际推广价值。在养老机构场景中,系统可用于信息化升级与日常运营管理优化,有效提升护工工作效率,降低人工巡检成本,并实现对跌倒等高风险事件的实时监测与快速响应。
在社区养老场景中,系统可作为轻量化智能监护平台进行部署,结合区域养老服务体系,实现对老年人健康状态的集中管理与统一调度。在居家养老场景中,系统可通过摄像头与可穿戴设备的组合,实现对老人基础生命体征与行为状态的远程监护,满足家庭级养老安全需求。
此外,系统采用模块化与服务化架构设计,具备良好的可扩展性与部署灵活性,可根据不同规模与应用需求进行功能裁剪与快速部署,具备一定的工程落地与规模化推广基础。
6.3 作品展望
尽管本系统已完成核心功能设计与实现,但在实际应用与进一步推广过程中仍存在优化空间,未来可从以下几个方向进一步提升系统能力。
在交互体验方面,可进一步完善家属端功能,从当前的信息查询扩展至更直观的数据可视化展示与远程互动能力,使家属能够更便捷地了解老人状态,提升系统的实际使用价值与用户粘性。
在智能能力方面,可继续优化多模态感知与视觉识别模型,引入更高精度的融合算法,以提升复杂场景(如遮挡、光照变化、多目标干扰)下的识别准确率,同时降低误报与漏报率;同时增强基于LangChain 的Agent 能力,使其具备更强的任务规划与长期记忆能力,进一步提升系统的主动决策水平。
在应用拓展方面,系统可由养老院场景逐步扩展至居家养老、社区养老及医疗护理等领域,通过模块复用与功能裁剪实现多场景适配,构建更广泛的智慧健康管理生态体系。
总体而言,本系统已具备一定的应用基础,但在智能化水平、稳定性与多场景适配能力方面仍有提升空间,后续将结合实际部署反馈持续迭代优化。
参考文献
[1] 中华人民共和国国家统计局. 2010 年第六次全国人口普查主要数据公报(第 1 号)[EB/OL]. (2011-04-28)[ 引用日期 ]. https://www.stats.gov.cn/sj/tjgb/rkpcgb/qgrkpcgb/202302/t20230206_1901997.html. [2] 王萍萍. 2025 年全国人口总量为140489 万人 人口高质量发展持续推进 [EB/OL]. (2026-01-19)[2026-4-12]. https://www.stats.gov.cn/sj/sjjd/202601/t20260119_1962338.html. [3] 国家统计局, 国务院第七次全国人口普查领导小组办公室. 第七次全国人口普查公报(第一号):第七次全国人口普查工作基本情况[EB/OL]. (2021-05- 11)[2026-4-12]. https://www.gov.cn/guoqing/2021-05/13/content_5606149.htm. [4] 中华人民共和国国务院. 关于深入实施“人工智能+”行动的意见[EB/OL]. (2025-08-27)[2026-4-12]. http://www.cppcc.gov.cn/zxww/2025/08/27/ARTI1756258113664166.shtml#10006- weixin-1-52626-6b3bffd01fdde4900130bc5a2751b6d1. [5] 帅文璇.基于智慧养老云平台的摔倒检测算法的研究与应用[D].北京邮电大学,2024.DOI:10.26969/d.cnki.gbydu.2024.002311. [6] 姜婵. 基于智能可穿戴设备的智慧养老平台的探索[J]. 办公自动化,2024,29(24):90-92. [7] 张欣悦.基于服务接触理论的智慧社区养老服务系统设计研究[D].华东理工大学,2025.DOI:10.27148/d.cnki.ghagu.2025.000219.